Erst zugänglich, dann lesbar. Dann zitierfähig.
Das Wichtigste in Kürze
- Eine Website muss für KI-Crawler zuerst zugänglich, dann lesbar und erst dann zitierfähig sein; ohne dieses technische Fundament verpufft jede inhaltliche Optimierung.
- KI-Crawler wie GPTBot oder ClaudeBot werden am häufigsten unbeabsichtigt blockiert, etwa durch Sicherheits-Plugins, Firewalls oder pauschale robots.txt-Regeln, nicht durch bewusstes Aussperren.
- Die meisten großen KI-Crawler führen kein JavaScript aus: Inhalte, die erst im Browser nachgeladen werden, sind für sie unsichtbar, auch wenn Besucher sie problemlos sehen (Vercel/MERJ-Auswertung, Dezember 2024). Googles Gemini bildet dabei eine Ausnahme.
- Schema-Markup wie Organization, Service oder FAQPage hat laut HubSpots State of AEO 2026 einen messbaren Zusammenhang mit höheren Zitierraten auf Google AI Mode und Gemini; wie stark strukturierte Daten Zitierungen direkt beeinflussen, gilt aber als umstritten.
- In einem Praxisbeispiel blockierte ein Sicherheits-Plugin sämtliche KI-Crawler auf Firewall-Ebene, ohne dass dies in der robots.txt sichtbar war; nach der Bereinigung tauchte das Unternehmen innerhalb weniger Wochen erstmals in KI-Antworten auf.
Technische KI-Readiness: Was eure Website erfüllen muss, damit KI-Systeme sie lesen können
Viele reden über Inhalte für KI-Systeme – kaum jemand über die technische Basis. Die besten Inhalte nützen nichts, wenn KI-Crawler sie nicht erreichen, rendern oder verarbeiten können.
Viele sprechen über Inhalte für KI-Systeme – aber kaum jemand über die technische Basis. Dabei gilt: Die besten Inhalte nützen nichts, wenn KI-Crawler sie nicht erreichen, nicht rendern oder nicht verarbeiten können.
Dieser Artikel geht die technischen Voraussetzungen der Reihe nach durch – mit konkreten Prüfschritten, die ihr direkt umsetzen könnt.
KI-Crawler zulassen – oder bewusst ausschließen
KI-Anbieter nutzen eigene Crawler mit eigenen Namen. Die wichtigsten: GPTBot und OAI-SearchBot (OpenAI/ChatGPT), ClaudeBot (Anthropic/Claude) und Google-Extended – letzteres steuert die Nutzung für Googles KI-Modelle, nicht die normale Suche.
Gesteuert wird der Zugriff über die robots.txt eurer Website. Der häufigste Fehler ist nicht das bewusste Sperren, sondern das unbeabsichtigte: Sicherheits-Plugins, Firewalls oder pauschale robots.txt-Regeln sperren KI-Crawler aus, ohne dass es jemand merkt.
Prüfschritt: Öffnet euredomain.de/robots.txt und sucht nach den Crawler-Namen und nach pauschalen Disallow-Regeln. Prüft zusätzlich in Server-Logs oder im CDN-Dashboard, ob Anfragen dieser Bots blockiert werden.
Erst zugänglich, dann lesbar, dann zitierfähig. In dieser Reihenfolge.
Leitprinzip KI-Readiness
Inhalte als Text: das JavaScript-Problem
KI-Crawler verarbeiten in erster Linie den ausgelieferten HTML-Text. Und hier liegt ein Problem, das viele moderne Websites betrifft: Die großen KI-Crawler führen kein JavaScript aus. Vercel und MERJ haben dafür in der Untersuchung „The Rise of the AI Crawler“ (Dezember 2024) den Crawler-Verkehr im Vercel-Netzwerk ausgewertet, darunter 569 Millionen Abrufe von OpenAIs GPTBot und 370 Millionen von Anthropics ClaudeBot innerhalb eines Monats. Der Befund: Diese Bots fordern JavaScript-Dateien zwar an, führen sie aber nicht aus, und lesen deshalb keine clientseitig gerenderten Inhalte. Googles Gemini bildet eine Ausnahme, weil es die Rendering-Infrastruktur von Googlebot mitnutzt. Inhalte, die erst im Browser nachgeladen werden, sind für die übrigen Systeme unsichtbar – auch wenn Besucher:innen sie einwandfrei sehen. Der Stand ist Dezember 2024, und das Feld bewegt sich schnell: Welche Bots rendern, kann sich ändern.
Kritisch sind außerdem Inhalte, die nur in Bildern oder Grafiken stehen, ausschließlich in PDF-Broschüren liegen oder hinter Logins, Formularen und Cookie-Walls versteckt sind.
Prüfschritt: Ruft eure wichtigsten Seiten mit deaktiviertem JavaScript auf oder seht euch den Seitenquelltext an. Alles, was dort nicht als Text steht, existiert für viele KI-Crawler nicht.
Strukturierte Daten einsetzen
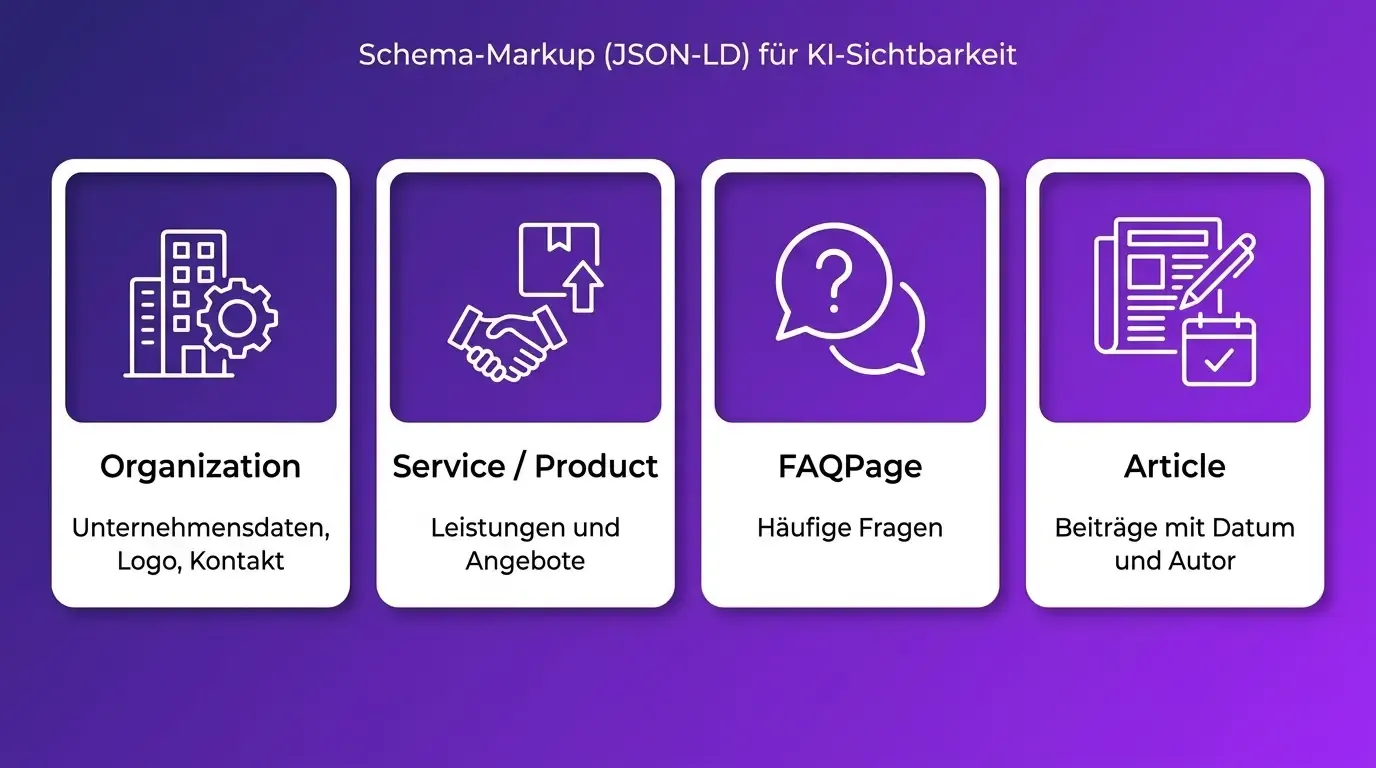
Schema-Markup im Format JSON-LD beschreibt Maschinen, worum es auf einer Seite geht und wie die Elemente zusammenhängen. Besonders relevant im B2B: Organization (Unternehmensdaten, Logo, Kontakt), Service/Product (Leistungen), FAQPage (häufige Fragen) und Article (Blogbeiträge mit Datum und Autor:in).
Wie stark strukturierte Daten Zitierungen direkt beeinflussen, ist umstritten. HubSpots State of AEO 2026 fand jedoch einen messbaren Zusammenhang: Seiten, die eine Q&A-Sektion mit FAQ-Markup kombinierten, erzielten auf Google AI Mode und Gemini höhere Zitierraten. Der Aufwand ist gering, das Risiko null.
Prüfschritt: Testet eure wichtigsten Seiten mit dem Rich-Results-Test von Google oder dem Schema-Validator (validator.schema.org).
Ladezeit, Erreichbarkeit & konsistente Daten
Auch KI-Crawler haben begrenzte Ressourcen. Websites, die langsam laden oder häufig Fehler ausgeben, werden seltener und unvollständiger erfasst. Die Basics: Ladezeit unter zwei bis drei Sekunden, saubere interne Verlinkung, eine aktuelle XML-Sitemap in der robots.txt referenziert, keine 404-Fehler oder Redirect-Ketten auf zentralen Seiten.
Dazu kommt die Konsistenz eurer Unternehmensdaten im Netz. KI-Systeme gleichen Informationen über verschiedene Quellen ab, um Entitäten zu erkennen: Ist die Firma auf der Website dieselbe wie im LinkedIn-Profil und im Branchenverzeichnis? Widersprüchliche Angaben schwächen dieses Vertrauen – und damit die Wahrscheinlichkeit, als Quelle herangezogen zu werden.
Prüfschritt: Vergleicht Firmenname, Leistungsbeschreibung und Kontaktdaten auf Website, LinkedIn, Google-Unternehmensprofil und den zwei bis drei wichtigsten Branchenverzeichnissen. Vereinheitlicht Abweichungen, entfernt veraltete Einträge.
Die komplette Checkliste im Überblick
- robots.txt: KI-Crawler bewusst erlauben oder blockieren – keine unbeabsichtigten Sperren
- Firewall/CDN: Bot-Schutz auf blockierte KI-Crawler prüfen
- Kerninhalte als HTML-Text, nicht nur per JavaScript, in Bildern oder PDFs
- Schema-Markup: mindestens Organization, Service und FAQPage
- Ladezeit unter drei Sekunden, XML-Sitemap aktuell, keine toten Links
- Unternehmensdaten über alle Plattformen konsistent
Werkzeug zum Weiterarbeiten
Wer nach dem technischen Fundament wissen will, wie sichtbar das eigene Unternehmen heute ist, findet im Report einen Selbsttest mit zehn Prompts in vier KI-Systemen, dazu fertige JSON-LD- und llms.txt-Bausteine und einen 90-Tage-Fahrplan.
Praxisbeispiel: drei Blocker, ein Fix
Ein Maschinenbauunternehmen wunderte sich, warum es trotz inhaltlich guter Website in keiner KI-Antwort auftauchte. Der technische Check ergab gleich drei Blocker: Ein Sicherheits-Plugin sperrte sämtliche KI-Crawler auf Firewall-Ebene – in der robots.txt war davon nichts zu sehen. Die zentralen Leistungsbeschreibungen lagen ausschließlich in PDF-Broschüren. Und die Unternehmensdaten widersprachen den Einträgen in zwei Branchenportalen.
Nach der Bereinigung – Firewall-Ausnahmen für die wichtigsten KI-Crawler, Leistungsinhalte als reguläre HTML-Seiten mit FAQ-Markup, vereinheitlichte Verzeichniseinträge – wurden die Inhalte innerhalb weniger Wochen von ChatGPT erfasst. Beim monatlichen Prompt-Test tauchte das Unternehmen erstmals in Anbieterlisten auf.
KI-Readiness beginnt nicht beim Content, sondern bei der Technik. Die gute Nachricht: Die Prüfung kostet einen Nachmittag, die meisten Fixes sind schnell umgesetzt – und ohne dieses Fundament verpufft jede Content-Optimierung. Erst zugänglich, dann lesbar, dann zitierfähig. In dieser Reihenfolge.
Häufige Fragen
Der Abschnitt spiegelt die echten Prompts aus Google AI & ChatGPT rund um technische KI-Readiness wider.
Wie erlaube ich KI-Crawler wie GPTBot in der robots.txt?
Über einen expliziten User-agent-Eintrag für den jeweiligen Bot (z. B. GPTBot) ohne Disallow. Wichtig ist vor allem, unbeabsichtigte Sperren durch Sicherheits-Plugins oder Firewalls auszuschließen.
Warum taucht meine Website nicht in KI-Antworten auf?
Häufigste technische Ursachen: KI-Crawler werden auf Firewall-Ebene blockiert, Kerninhalte liegen nur in JavaScript, Bildern oder PDFs, oder die Unternehmensdaten sind im Netz widersprüchlich.
Verarbeiten KI-Crawler JavaScript?
In der Regel nur eingeschränkt oder gar nicht. Inhalte, die erst im Browser nachgeladen werden, sind für viele KI-Systeme unsichtbar. Kerninhalte gehören als HTML-Text ausgeliefert.
Brauche ich Schema-Markup für die KI-Suche?
Der direkte Effekt ist umstritten, der Aufwand aber gering und das Risiko null. Mindestens Organization, Service und FAQPage sind sinnvoll.
Was ist der Unterschied zwischen GPTBot und Google-Extended?
GPTBot ist der Crawler von OpenAI/ChatGPT. Google-Extended steuert nur die Nutzung eurer Inhalte für Googles KI-Modelle – nicht die normale Google-Suche.
Wie schnell muss meine Website für KI-Crawler laden?
Als Richtwert unter zwei bis drei Sekunden. Langsame oder fehleranfällige Seiten werden seltener und unvollständiger erfasst.
Quellen & Weiterführende Literatur
- HubSpot – State of AEO 2026
- Google Rich Results Test (search.google.com/test/rich-results)
- Schema.org Validator (validator.schema.org)