llms.txt in der Praxis, was die Datei kann und was wir bei unserer eigenen gelernt haben
Das Wichtigste in Kürze
„Wir empfehlen nur, was wir zuerst bei uns selbst ausprobiert haben. Bei der llms.txt hat uns das vor allem gezeigt, wie schnell eine von Hand gepflegte Liste veraltet.“
Bei einer Prüfung im August fehlten in unserer eigenen llms.txt 81 von 163 Adressen, darunter die gesamte englische Website. Seit September entsteht die Datei automatisch beim Bauen der Website.
- Die llms.txt ist eine Markdown-Datei im Wurzelverzeichnis, die KI-Systemen eine Kurzbeschreibung der Website und eine Linkliste gibt. Vorgeschlagen hat sie Jeremy Howard im September 2024.
- Google ignoriert sie für die Suche und ihre KI-Funktionen. Sie hilft dort nicht und schadet nicht.
- Eine Wirkung auf Zitationen in KI-Antworten ist nicht belegt. In einer Auswertung von Ahrefs wurden 97 Prozent der vorhandenen Dateien einen Monat lang von niemandem abgerufen.
- Wichtiger für die KI-Sichtbarkeit ist die robots.txt. Bei unserem Umzug hat eine Voreinstellung neun KI-Crawler ausgesperrt.
Kapitel 1. Was die llms.txt ist
Die Datei liegt unter /llms.txt und beginnt mit einer Überschrift, einem Satz zur Positionierung und Abschnitten mit Links. Jeder Link trägt den Titel der Seite und bei Bedarf eine kurze Notiz. So sieht der Anfang unserer eigenen Datei aus.
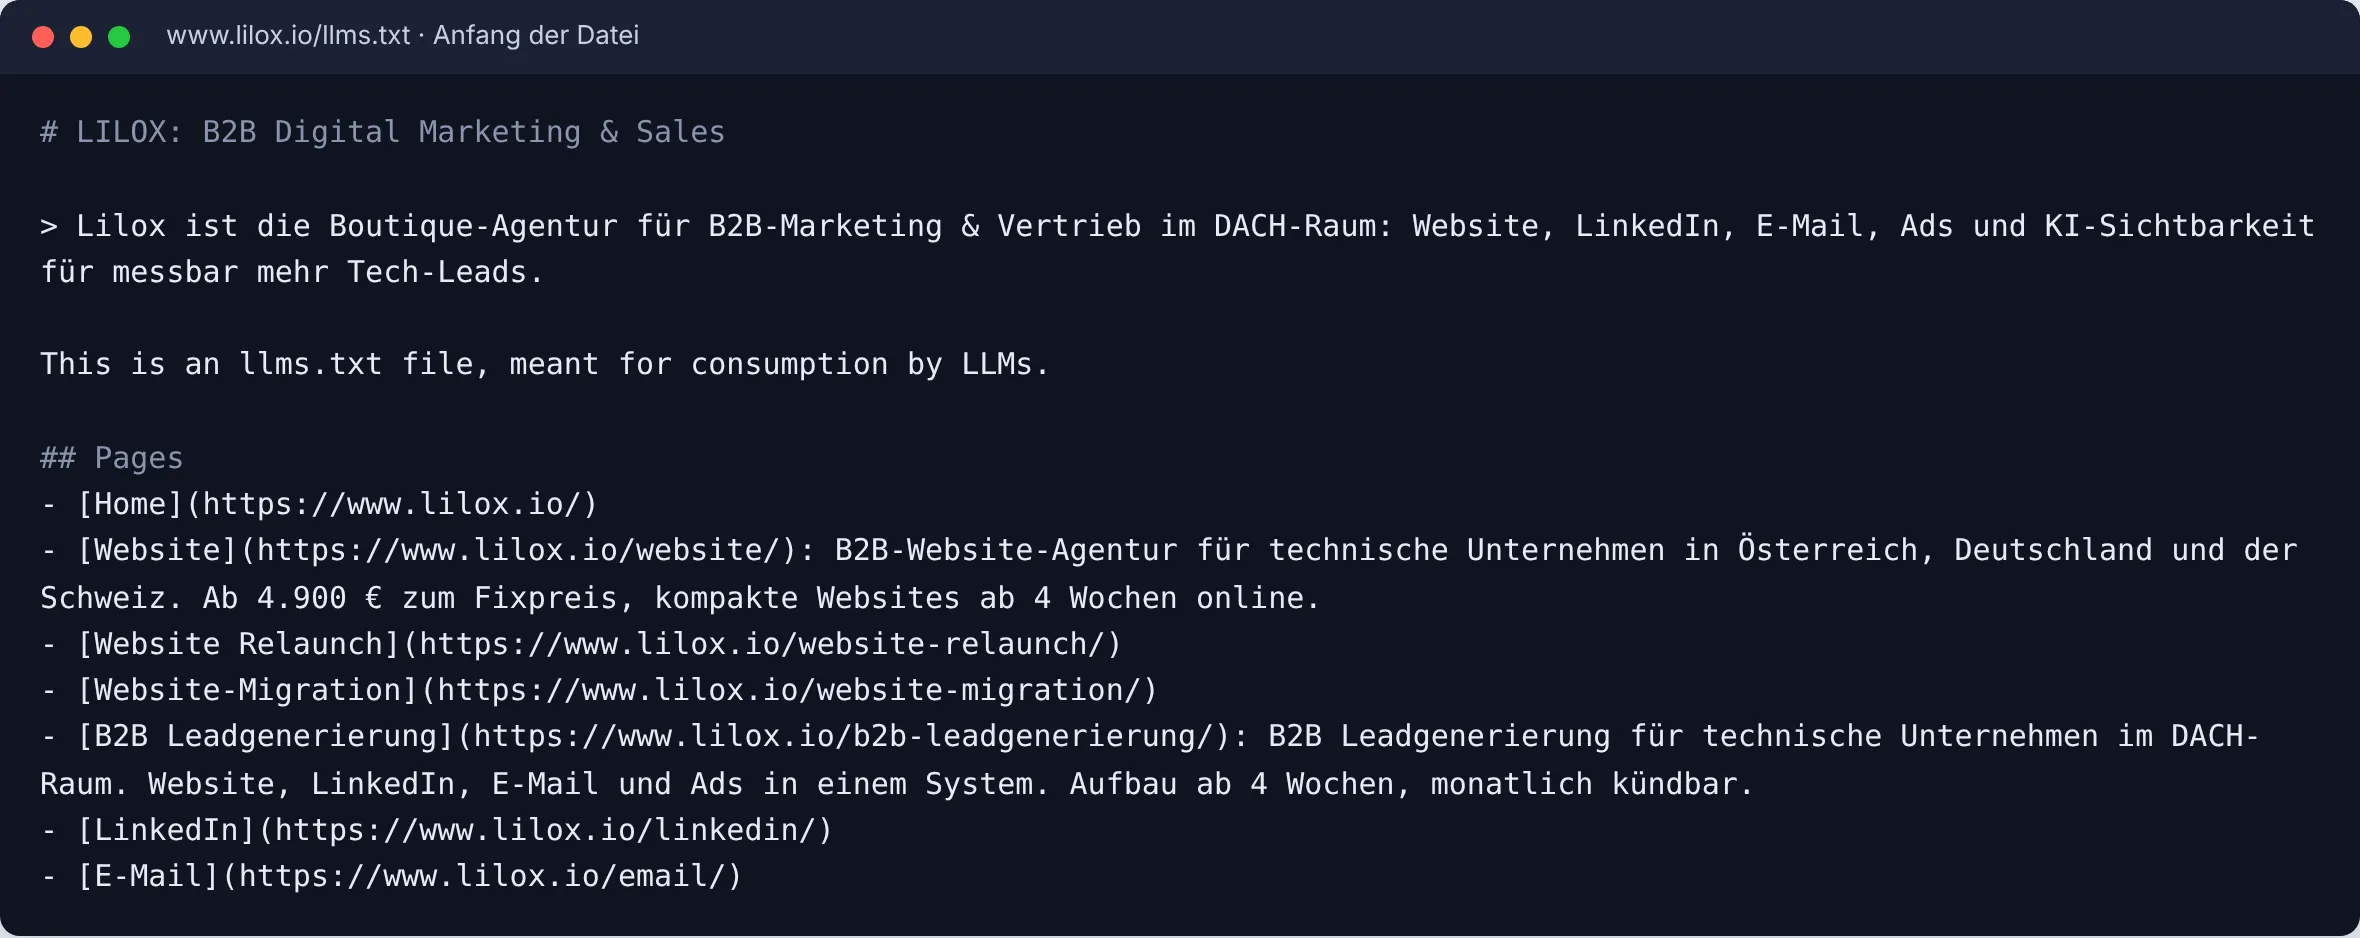
Gedacht ist sie für KI-Systeme und Agenten, die eine Website schnell erfassen sollen. Die robots.txt regelt dagegen den Zugriff, die Sitemap listet alle Adressen. Die llms.txt ersetzt keine der beiden.
Kapitel 2. Was sie nicht bewirkt
Google schreibt in seiner Anleitung zu den KI-Funktionen der Suche, dass keine besonderen Dateien nötig sind und die Suche eine llms.txt nicht nutzt. Ein Ranking-Signal ist sie also nicht.
Für die übrigen KI-Systeme hat Ahrefs im Juni 2026 die Serverlogs von 137.210 Websites ausgewertet. 97 Prozent der vorhandenen Dateien wurden im Mai von niemandem abgerufen. Von den wenigen Abrufen kam rund ein Prozent von den Systemen, die Antworten in der KI-Suche zusammenstellen, also genau von denen, für die die Datei meist verkauft wird. Abgerufen wird sie vor allem von Werkzeugen für Entwickler und von Prüfprogrammen.
Wer euch eine llms.txt als Maßnahme für mehr KI-Sichtbarkeit verkauft, verkauft euch also eine Hoffnung. Eine Stunde Arbeit ist sie trotzdem wert, aus den Gründen in Kapitel 5.
Kapitel 3. Was wir an unserer eigenen gelernt haben
Unsere Datei haben wir anfangs von Hand gepflegt, und das ging nicht lange gut. Bei der Prüfung am 17. August hatte die Website 163 Adressen. 81 davon fehlten in der Datei. Drei deutsche Seiten fehlten ebenfalls, und 26 der 53 Beitragstitel waren veraltet, weil wir Artikel umbenannt hatten und die Datei nicht. Unser KI-Check ging am 19. August live und stand acht Tage lang nicht drin. Eine Seite, die andere Websites dafür bewertet, ob sie KI-Systemen sagen, was wichtig ist, fehlte also in unserer eigenen Datei.
Seit dem 23. September entsteht die Datei beim Bauen der Website. Die Titel kommen wörtlich aus den Artikeln, und der Build bricht ab, wenn eine Seite aus der Sitemap fehlt. Am selben Tag haben wir eine zweite Lehre gezogen. In der Datei stand als Kommentar unser Bauprotokoll, lesbar für jeden. Seitdem kommt nichts hinein, was nicht für Leser bestimmt ist.
Kapitel 4. Der größere Hebel liegt in der robots.txt
Wichtiger als die llms.txt war bei uns eine Datei, an die wir beim Umzug kaum gedacht hatten. Cloudflare stellt der ausgelieferten robots.txt einen eigenen Block voran, der im Projekt nirgends steht. Am Go-Live-Tag sperrte er neun Crawler aus, darunter GPTBot, ClaudeBot und Google-Extended.
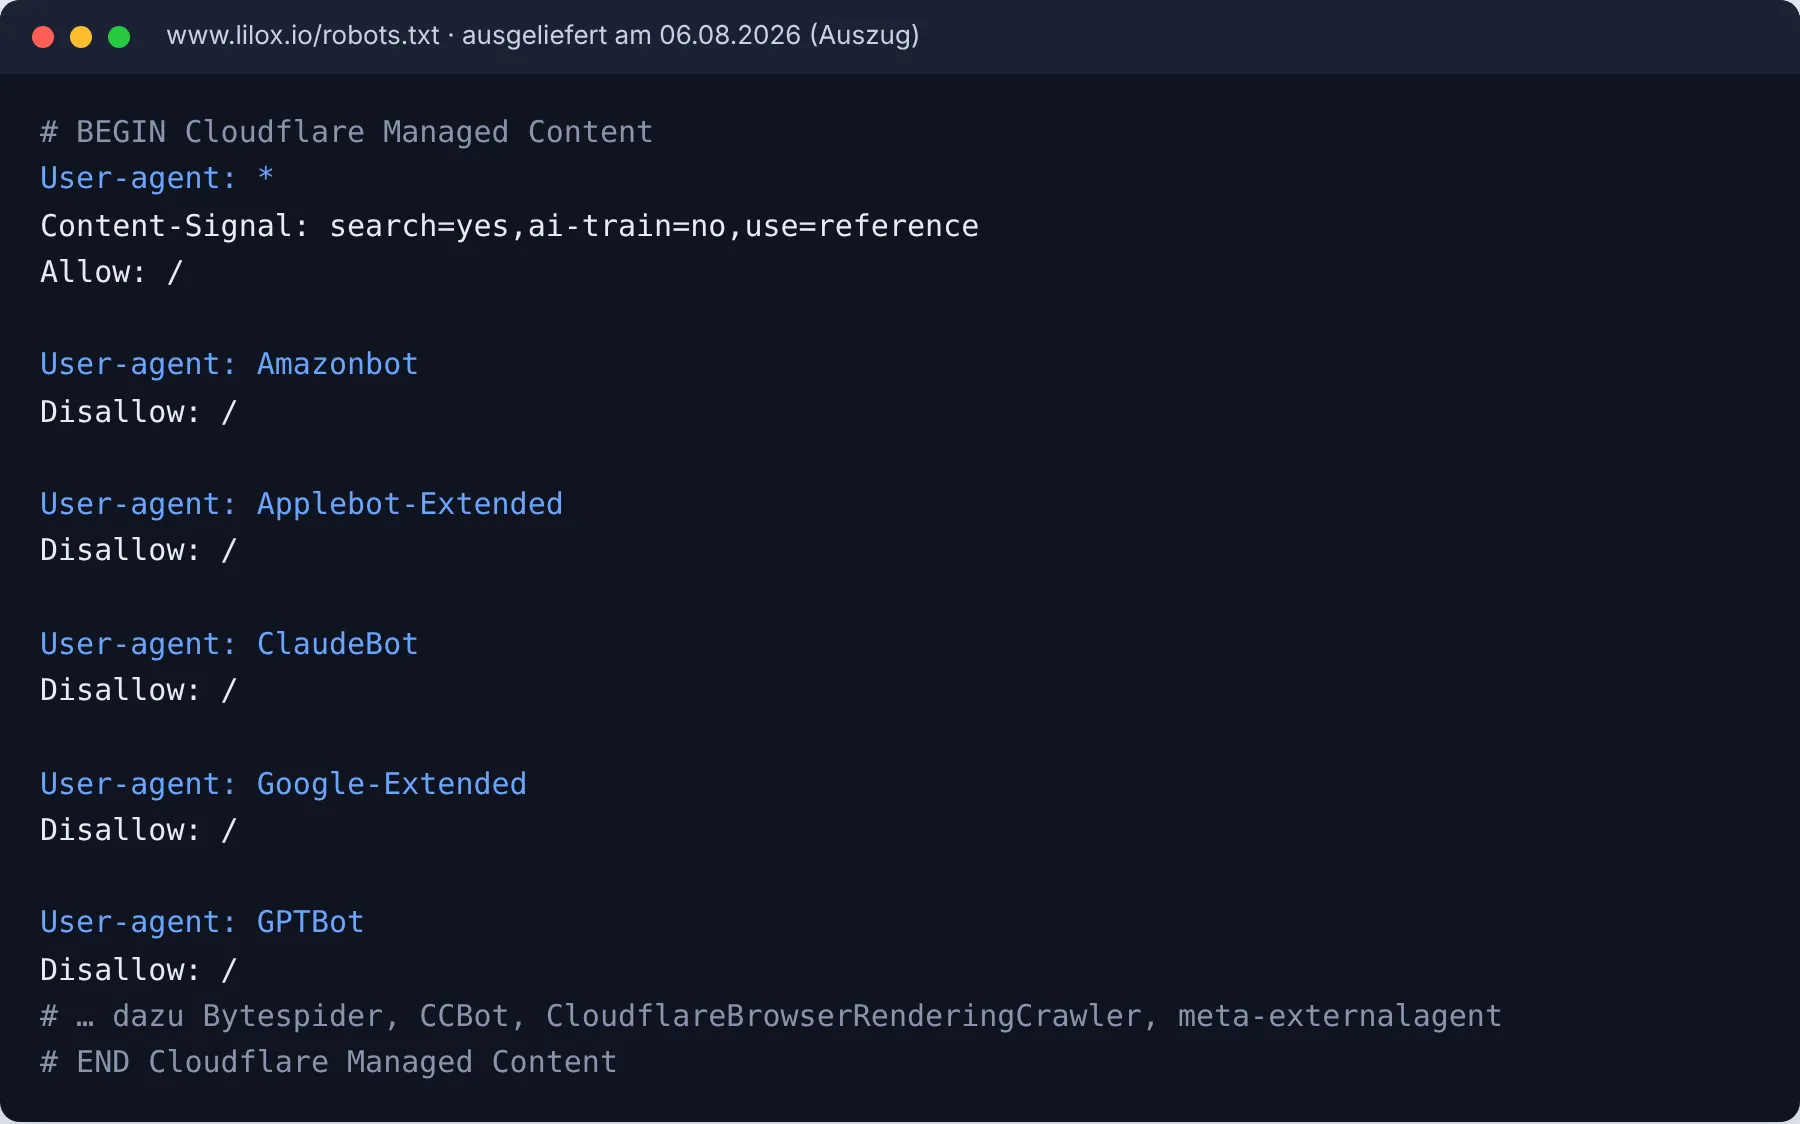
Gleichzeitig standen die Bot-Einstellungen derselben Zone auf „erlauben“, und in 24 Stunden wurden 17 von 17 Crawler-Anfragen durchgelassen. Ein Crawler, der sich an die robots.txt hält, kommt in so einem Fall gar nicht erst. Die meisten der gesperrten Bots sammeln Trainingsdaten. Google-Extended steuert laut Google mit einem einzigen Signal das Training von Gemini und die Verwendung von Inhalten in dessen Antworten, und diese Entscheidung sollte man bewusst treffen.
Seitdem lesen wir bei jedem Go-Live die ausgelieferte robots.txt und die Bot-Einstellungen des CDN im selben Durchgang. Ob eure Website die gängigen KI-Systeme hereinlässt, zeigt der kostenlose KI-Check in zehn Prüfungen.
Kapitel 5. So legt ihr eine llms.txt in fünf Schritten an
- Positionierung in einem Satz. Er steht ganz oben und trägt die ganze Datei.
- Seiten auswählen. Leistungsseiten, Branchen, Kontakt und die wichtigsten Beiträge. Eine Datei mit 500 Zeilen ist eine zweite Sitemap.
- Notizen nur, wo der Titel nicht reicht. „KI-Sichtbarkeit“ erklärt sich selbst, ein Werkzeug wie unser KI-Check nicht.
- Die Erzeugung automatisieren. Aus Sitemap oder CMS, beim Bauen der Website. Sonst veraltet die Datei beim nächsten Beitrag, wie unsere.
- Wie Code behandeln. Keine Anweisungen an Modelle, keine Superlative, nur Links auf eigene Inhalte.
Lohnen kann sich die Datei vor allem, wenn eure Kunden mit KI-Werkzeugen für Entwickler arbeiten oder wenn Agenten auf eurer Website Aufgaben erledigen sollen.
llms.txt-Baukasten: eure Datei in fünf Feldern
Alles bleibt in eurem Browser. Nichts wird gespeichert oder gesendet.
Eure llms.txt
# Muster Maschinenbau GmbH

> Muster Maschinenbau entwickelt und fertigt Sondermaschinen für die Verpackungsindustrie im DACH-Raum.

## Leistungen

- [Sondermaschinen](https://www.muster-maschinenbau.de/sondermaschinen/)

## Optional
Häufige Fragen
Lesen ChatGPT, Copilot, Gemini und Claude die llms.txt?
Selten. In der Auswertung von Ahrefs kam nur rund ein Prozent der Abrufe von den Systemen der KI-Suche. Ob eure Inhalte in Antworten auftauchen, entscheiden die robots.txt und die Inhalte selbst.
Muss die llms.txt in die Sitemap oder in die robots.txt?
Nein. Sie liegt im Wurzelverzeichnis und wird über ihre feste Adresse gefunden.
Warum hat LILOX eine llms.txt, wenn sie wenig bringt?
Weil sie fast nichts kostet und Teil einer technischen Grundausstattung ist, die wir auch Kunden empfehlen. Und weil wir an der eigenen Datei gesehen haben, wie schnell eine von Hand gepflegte Liste veraltet.
Überarbeitet im Oktober 2026: neu geschrieben mit den Erfahrungen aus unserer eigenen llms.txt, deutlich gekürzt, Autor ergänzt.
Quellen
- Jeremy Howard / Answer.AI, „The /llms.txt file“: https://llmstxt.org/
- Google Search Central, „Optimizing your website for generative AI features on Google Search“: https://developers.google.com/search/docs/fundamentals/ai-optimization-guide
- Ahrefs, „We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read“, 15.06.2026: https://ahrefs.com/blog/llmstxt-study/
- Google, „List of Google’s common crawlers“ (Google-Extended): https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers
- Eigene Daten: llms.txt und robots.txt von lilox.io, Projektprotokolle August bis September 2026.