Ihr messt eure KI-Sichtbarkeit. Und dann?
Das Wichtigste in Kürze
Ein Monitoring-Tool für KI-Sichtbarkeit misst, ob eure Marke in KI-Antworten vorkommt. Es sagt nicht, warum nicht, und es sagt erst recht nicht, was zu tun ist. Genau daran scheitern die meisten Setups: Nach vier bis sechs Wochen schaut niemand mehr hinein, weil aus keiner Zahl je eine Aufgabe wurde. Vier Kennzahlen tragen tatsächlich eine Entscheidung: Sichtbarkeit (kommt die Marke vor), Share of Voice (wie oft im Vergleich zum Wettbewerb), zitierte Quellen (woraus die Antwort gebaut ist) und technische Zutrittsfähigkeit (ob die eigene Seite überhaupt gelesen werden darf). Die vierte ist die einzige, die sich in Minuten prüfen und in Tagen beheben lässt, und sie ist zugleich die am häufigsten übersehene. Wer aus Monitoring Arbeit machen will, braucht drei feste Elemente: einen unveränderten Prompt-Satz, eine monatliche Auswertung mit Namen und Datum, und eine Regel, welche Abweichung welche Maßnahme auslöst.
Fast jedes Unternehmen, das wir zu diesem Thema sprechen, hat inzwischen ein Tool. Peec AI, Profound, Otterly, Semrush AI Toolkit, ein selbstgebautes Prompt-Sheet. Die Einrichtung dauert einen Nachmittag, die ersten Zahlen kommen am nächsten Tag, und dann passiert sechs Wochen lang nichts.
Das ist kein Disziplinproblem. Es ist ein Konstruktionsfehler im Aufbau.
Warum schaut nach sechs Wochen niemand mehr ins Dashboard?
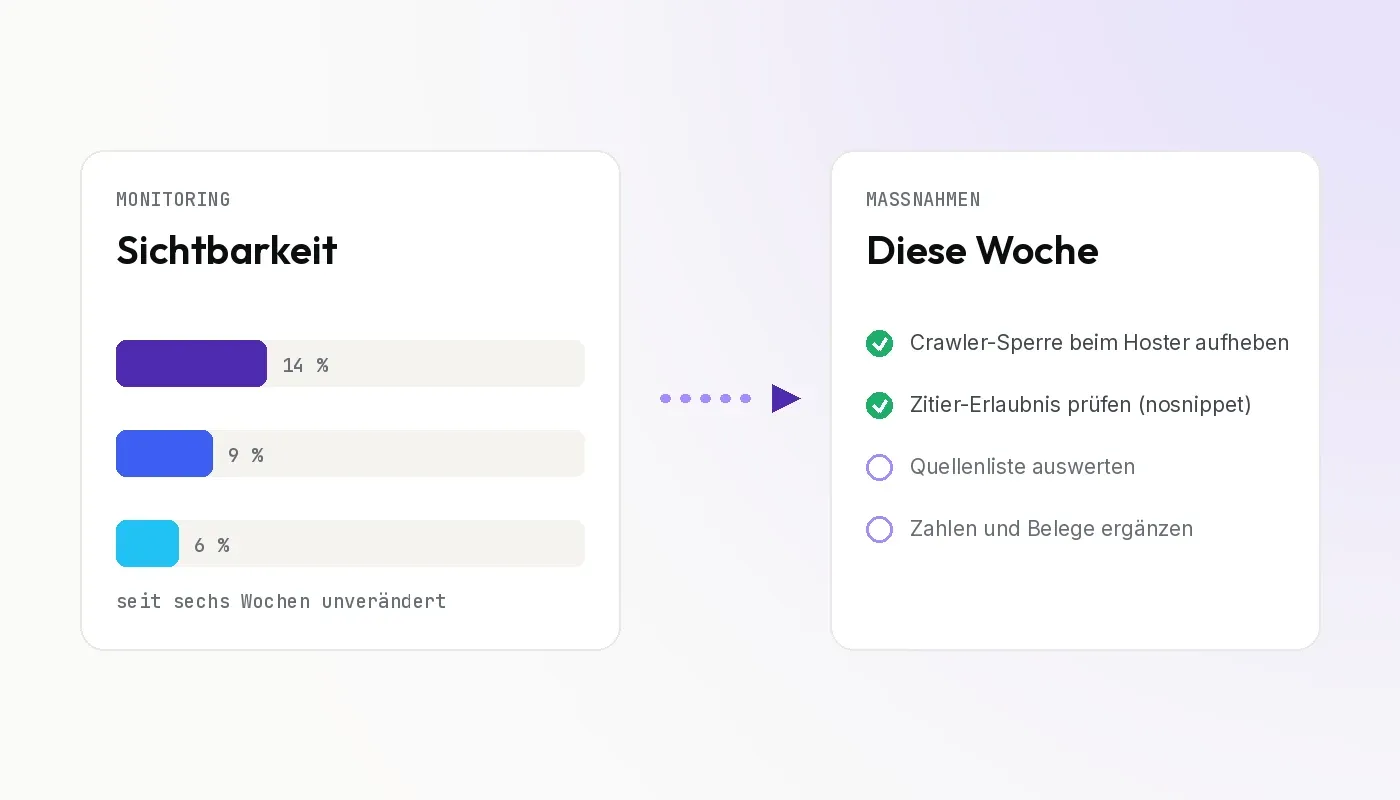
Weil ein Messwert ohne hinterlegte Handlung keine Information ist, sondern ein Gefühl. „Sichtbarkeit 14 Prozent“ beantwortet keine Frage, die jemand am Montagmorgen hat. Es ist weder gut noch schlecht, es hat keinen Vergleichswert, und es sagt nicht, wessen Aufgabe daraus folgt.
Klassisches SEO-Reporting hatte dieses Problem nicht, weil die Kette kurz war: Ranking fällt, Seite ansehen, Text nachbessern. Bei KI-Antworten ist die Kette länger und an mehreren Stellen unterbrochen. Zwischen „wir werden nicht genannt“ und „das können wir ändern“ liegen mindestens drei Fragen, die kein Dashboard beantwortet.
Erstens: Kommen die Systeme überhaupt auf unsere Seite? Zweitens: Wenn ja, finden sie dort etwas Zitierfähiges? Drittens: Wenn es an keinem von beidem liegt, aus welchen fremden Quellen bauen sie ihre Antwort stattdessen?
Ein Monitoring-Tool misst das Ergebnis dieser drei Fragen, nicht die Fragen selbst.
Welche vier Kennzahlen tragen eine Entscheidung?
Sichtbarkeit: kommt die Marke vor?
Der Anteil der Abfragen, in denen euer Unternehmen genannt wird. Die Basiszahl, aus der sich allein noch nichts ableiten lässt. Sie ist erst mit einem Vergleich brauchbar, entweder gegen den Vormonat oder gegen einen Wettbewerber.
Vorsicht bei einem verbreiteten Kurzschluss: Der Wert lässt sich jederzeit heben, indem man dem Prompt-Satz Fragen hinzufügt, in denen der eigene Markenname vorkommt. Die Zahl steigt, die Wirklichkeit nicht. Ein Prompt-Satz wird geändert, wenn eine echte Kundenfrage fehlt, nicht wenn die Kurve flach liegt.
Share of Voice: wie oft im Vergleich zu wem?
Der Anteil an allen genannten Anbietern. Diese Zahl ist unbequemer und deshalb nützlicher: Eine KI-Antwort nennt typischerweise drei bis fünf Anbieter, nicht dreißig. Sichtbarkeit ist damit ein Verdrängungsspiel, und ein Wert von 8 Prozent bedeutet etwas völlig anderes, wenn der stärkste Wettbewerber bei 40 liegt, als wenn alle bei 8 liegen.
Zitierte Quellen: woraus ist die Antwort gebaut?
Die einzige Kennzahl, die direkt in eine Maßnahme führt. Die meisten Tools listen zu jeder Antwort die abgerufenen und zitierten URLs. Daraus entsteht in wenigen Minuten eine Liste der Domains, aus denen die Antworten in eurem Markt gebaut werden.
Sie ist fast immer kurz, und sie enthält fast nie euch selbst. Was mit dieser Liste anzufangen ist, steht in einem eigenen Artikel: Warum KI-Antworten immer dieselben Quellen zitieren.
Technische Zutrittsfähigkeit: dürfen sie überhaupt?
Die Kennzahl, die in keinem Monitoring-Dashboard steht, und die einzige, die sich in Minuten prüfen lässt.
Ein Monitoring-Tool fragt die KI-Systeme ab. Es ruft eure Website nicht mit deren Crawler-Kennungen auf. Es kann deshalb strukturell nicht bemerken, wenn diese Crawler an eurer Tür abgewiesen werden, und genau das ist der häufigste Einzelbefund.
Cloudflare sperrt bekannte KI-Crawler seit Juli 2025 auf jeder neu angelegten Domain von sich aus, und weitet das zum 15. September 2026 auf alle Bestandskunden im Gratis-Tarif aus. Die Sperre ist eine Netzwerkregel, sie steht in keiner robots.txt, und der Seitenbetreiber sieht davon nichts. Ein zweiter, ähnlich unsichtbarer Fall ist ein nosnippet in den Robots-Angaben: Google nennt die Eignung für Textausschnitte ausdrücklich als Voraussetzung für AI Overviews und den AI Mode. Der Crawler kommt dann herein, liest alles, und darf nichts davon zeigen.
Beides lässt sich in unter einer Minute feststellen, kostenlos und ohne Anmeldung: KI-Sichtbarkeitscheck starten.
Was in keiner Kennzahl steht, aber die Zahlen erklärt
Drei technische Befunde entscheiden häufiger über eine fehlende Nennung als jede inhaltliche Schwäche.
KI-Crawler führen kein JavaScript aus. Das ist gemessen, nicht vermutet: Vercel hat gemeinsam mit MERJ über eine Milliarde Crawler-Abrufe ausgewertet und festgestellt, dass GPTBot, ClaudeBot und CCBot kein JavaScript ausführen. Eine Seite, die ihren Text erst im Browser zusammensetzt, ist für sie leer, unabhängig davon, wie gut sie aussieht.
Ein erheblicher Teil der Abrufe läuft ins Leere. Dieselbe Auswertung zeigt: 34,8 Prozent aller ChatGPT-Abrufe landeten auf einer 404-Seite, bei Googlebot waren es 8,2 Prozent. Veraltete interne Links und nicht gepflegte Weiterleitungen kosten hier unmittelbar Sichtbarkeit.
Belege im Text sind der bestbelegte Inhaltsfaktor. Die GEO-Untersuchung von Aggarwal und Kollegen hat in einem kontrollierten Versuch gemessen, welche Textänderungen den Anteil an KI-Antworten heben. Das Ergänzen von Zitaten und Quellenangaben brachte den größten Einzeleffekt: von 19,3 auf 27,2 Prozent, also rund 41 Prozent mehr. Eine unabhängige Auswertung über 55.936 Abfragen bestätigte den Zusammenhang für ausgehende Links auf externe Quellen.
Was oft empfohlen wird und der Prüfung nicht standhält
llms.txt anlegen. Google erklärt schriftlich, die Datei nicht zu lesen. Ahrefs hat 137.000 Seiten ausgewertet und fand: 97 Prozent der Dateien bekommen keinen Traffic. Sie schadet nicht und kostet zehn Minuten, aber sie ist keine Maßnahme, aus der eine Kennzahl steigt.
Mehr Schema.org auszeichnen. Der einzige quasi-experimentelle Test dazu, ebenfalls von Ahrefs, verglich 1.885 Seiten mit rund 4.000 Kontrollseiten und fand für AI Overviews einen leicht negativen und für ChatGPT keinen Effekt. Das Organization-Schema bleibt trotzdem sinnvoll, weil es die Frage beantwortet, welches Unternehmen hinter einer Seite steht. Als Hebel für mehr Nennungen taugt es nicht.
Die Ladezeit optimieren. In keiner uns bekannten Untersuchung zur KI-Zitierung taucht Ladezeit als Faktor auf. Sie misst Nutzererlebnis, und dafür ist sie richtig. Als Erklärung für eine fehlende Nennung ist sie eine Vermutung.
Wie wird aus Monitoring Arbeit?
Drei Elemente, und keines davon ist ein Werkzeug.
Ein unveränderter Prompt-Satz. Zwölf bis zwanzig Fragen im Wortlaut echter Kundenfragen, aufgeteilt in Kategorie-Anfragen, Problem-Anfragen und Marken-Anfragen. Er wird monatlich identisch gestellt. Wer ihn zwischendurch ändert, hat keine Zeitreihe mehr, sondern zwei unvergleichbare Momentaufnahmen.
Eine monatliche Auswertung mit Namen und Datum. Eine Seite, nicht zehn: die vier Kennzahlen, der Vergleich zum Vormonat, die Liste der zitierten Fremdquellen, und darunter drei Sätze, was daraus folgt. Ohne eine Person, die sie schreibt, gibt es sie nach dem zweiten Monat nicht mehr.
Eine Regel, welche Abweichung welche Maßnahme auslöst. Diese Regel ist das eigentlich fehlende Stück. Ein Beispiel, das sich direkt übernehmen lässt:
- Zutritt für einen Zitier-Crawler gesperrt: sofort beheben, Hoster-Einstellung, gleiche Woche
- Share of Voice sinkt zwei Monate in Folge, während die Sichtbarkeit gleich bleibt: der Wettbewerb wächst, nicht wir. Off-Site-Arbeit an den zitierten Quellen
- Dieselbe Fremdquelle taucht in mehr als der Hälfte der Antworten auf: Aufnahme in diese Quelle prüfen
- Wir werden genannt, aber falsch beschrieben: Entity-Arbeit, also Positionierungstext,
Organization-Daten und externe Profile angleichen - Keine Bewegung über drei Monate bei sauberem Zutritt: es fehlt zitierfähiger Inhalt, kein technisches Problem
Werkzeug zum Weiterarbeiten
Wer den Prompt-Satz nicht bei null beginnen will, findet im Report 51 Einkäufer-Fragen, eine Messung über 30 Tage in vier KI-Systemen und die sechs Befunde, die daraus folgen.
Wie lange dauert es, bis sich etwas bewegt?
Die technischen Befunde wirken schnell: Ein aufgehobener Crawler-Zugang ist innerhalb weniger Tage bis Wochen in den Antworten sichtbar, weil die Systeme die Seite dann erstmals holen können. Alles, was mit Inhalten und externen Nennungen zu tun hat, braucht länger, üblicherweise vier bis acht Wochen bis zu ersten Bewegungen und mehrere Monate bis zu einem stabilen Bild.
Wer nach vier Wochen keine Veränderung sieht, hat entweder ein technisches Problem, das nicht behoben wurde, oder er misst einen Zeitraum, der zu kurz ist. Das lässt sich unterscheiden, und der Unterschied ist die erste Frage, die eine Auswertung beantworten muss.
Wie Lilox das aufsetzt
Wir beginnen nicht mit dem Tool, sondern mit dem Prompt-Satz und dem technischen Befund. Der Prompt-Satz entsteht aus dem, was Kunden in Gesprächen tatsächlich fragen, nicht aus Keyword-Listen. Der technische Befund entsteht aus echten Abrufen mit den Crawler-Kennungen der Antwortsysteme, weil sich sonst nicht trennen lässt, ob eine fehlende Nennung am Inhalt oder an einer geschlossenen Tür liegt.
Aus beidem entsteht die monatliche Auswertung mit der Maßnahmenregel. Der Bericht, die Struktur und die Zugänge gehören am Ende dem Unternehmen, nicht uns.
Häufige Fragen
Wie misst man KI-Sichtbarkeit?
Mit einem festen Satz aus zwölf bis zwanzig Fragen im Wortlaut echter Kundenfragen, monatlich unverändert in ChatGPT und Gemini gestellt. Je Antwort werden vier Dinge festgehalten: ob die Marke genannt wird, an welcher Position, mit welcher Begründung, und wer stattdessen genannt wird. Tools wie Peec AI automatisieren diese Messung. Der Prompt-Satz selbst muss aber von Menschen aus echten Kundenfragen gebaut werden, sonst misst er die falschen Fragen sehr genau.
Warum ändert sich trotz Monitoring nichts an unserer Sichtbarkeit?
Weil Monitoring das Ergebnis misst und nicht die Ursache. Ein Dashboard zeigt, dass ihr nicht genannt werdet, aber nicht, ob die Crawler eure Seite überhaupt betreten dürfen, ob sie dort Text vorfinden und ob die Antworten aus fremden Quellen gebaut werden. Diese drei Fragen brauchen eigene Prüfungen, und aus ihren Antworten entsteht die Maßnahmenliste, die das Monitoring nicht liefern kann.
Welche Kennzahl ist die wichtigste für KI-Sichtbarkeit?
Die Liste der zitierten Quellen. Sichtbarkeit und Share of Voice sagen, wo ihr steht, aber die zitierten Quellen sagen, woraus die Antworten in eurem Markt gebaut werden. Diese Liste ist meist kurz, enthält selten die Anbieter selbst, und sie ist die einzige Kennzahl, aus der sich direkt eine Arbeitsliste ableiten lässt.
Reicht ein Monitoring-Tool, oder brauchen wir eine Agentur?
Das Tool liefert die Messung, es liefert weder die Fragen noch die Deutung noch die Umsetzung. Wer intern jemanden hat, der monatlich eine Stunde für die Auswertung und mehrere Tage für die Maßnahmen aufbringt, braucht keine Agentur. Wer feststellt, dass das Dashboard seit Wochen niemand geöffnet hat, hat kein Werkzeugproblem, sondern ein Prozessproblem, und das löst kein weiteres Abo.
Woran erkenne ich, ob unsere Website technisch überhaupt zitierfähig ist?
Indem jemand sie mit den echten Crawler-Kennungen abruft und prüft, ob sie durchkommen, ob ohne JavaScript Text übrig bleibt und ob die Robots-Angaben Textausschnitte erlauben. Ein Blick in die robots.txt reicht dafür nicht, weil die häufigste Sperre eine Netzwerkregel des Hosters ist und dort gar nicht auftaucht. Unser KI-Sichtbarkeitscheck prüft das in zehn Prüfungen, kostenlos und ohne Anmeldung.